


Shell 脚本之 Shell 三剑客
一、Shell 三剑客概述
1. Shell 三剑客
Shell 三剑客是指grep、sed和awk这三个在Linux/Unix系统中常用的命令行工具。
grep:grep 是一个文本搜索工具,用于根据给定的模式(正则表达式)在文件或输入流中搜索匹配的行。grep 的主要作用是查找和过滤特定文本。
sed:sed 是一个流编辑器,可以对文本进行查找、替换、删除等操作。它可以直接在文本流中编辑,不需要打开文件,非常适合批量处理。
awk:awk 是一个文本处理工具,适合对列进行处理和分析。它不仅可以进行查找和替换,还能执行数学计算和数据统计,特别适合处理以列形式组织的数据,如日志、CSV 文件等。
面试题:grep、sed、awk有何区别?
- grep用于查找特定内容,适合快速过滤日志或配置文件。
- sed 用于修改和编辑文本,非常适合批量替换或删除操作。
- awk 更强大,适用于列状数据的处理,能够提取字段、统计数据或进行数学计算。
在运维工作中,应该根据不同的需求选择合适的工具:当需要简单查找时用 grep,批量修改文件时用 sed,处理复杂的日志或统计数据时使用 awk。
2. Shell 三剑客适用场景
① 日志处理与搜索:使用 grep 搜索关键词,结合 sed 和 awk 进行进一步处理和分析。
② 配置文件管理:使用 sed 和 awk 进行批量修改、添加或删除配置项。
③ 数据提取与转换:利用 awk 提取、分析和转换结构化文本数据,处理 CSV、JSON 等格式。
④ 监控与报警:使用 grep、sed 和 awk 提取关键信息生成监控报告,监控系统状态和性能。
⑤ 日常运维任务:自动化任务,如查找过期文件、清理日志、统计日志大小等。
⑥ 系统管理:使用 sed 和 awk 处理系统状态信息,如用户信息、进程信息、磁盘使用情况等。
3. Shell 三剑客执行说明
默认情况下,grep、sed以及awk在处理数据时默认都是按行处理
二、Shell 三剑客之 grep 工具
1. grep 基本语法
grep 主要作用:过滤来自一个文件或标准输入匹配模式内容。
除了 grep 外,还有 egrep;egrep 是 grep 的扩展,相当于 grep -E。
基本语法:grep [OPTION]... PATTERN [FILE]...
| 支持的正则 | 描述 |
|---|---|
| -E,--extended-regexp | 模式是扩展正则表达式(ERE) => 字符簇、()、|或 |
| -P,--perl-regexp | 模式是Perl正则表达式 => \d、\w、\s |
| -i,--ignore-case | 忽略大小写 |
| -w,--word-regexp | 模式匹配整个单词 |
| -v,--invert-match | 打印不匹配的行 |
| 输出控制 | 描述 |
|---|---|
| -n,--line-number | 打印行号 |
| -h,--no-filename | 不输出文件名 |
| -o,--only-matching | 只打印匹配的内容 |
| -r,--recursive | 递归目录 |
| -c,--count | 统计匹配行数 |
2. grep 案例演示
准备数据集
cat >demo.txt<<EOF
Hello World!
hello grep!
Hello, this is an example file.
Hello, this is an Example file.
It contains some lines of text.
hello, this is an example file.
Let's use grep to search for specific patterns.
EOF
[root@hab1 /shell]# cat >demo.txt<<EOF
Hello World!
hello grep!
Hello, this is an example file.
Hello, this is an Example file.
It contains some lines of text.
hello, this is an example file.
Let's use grep to search for specific patterns.
EOF
[root@hab1 /shell]# cat demo.txt
Hello World!
hello grep!
Hello, this is an example file.
Hello, this is an Example file.
It contains some lines of text.
hello, this is an example file.
Let's use grep to search for specific patterns.
案例1:在文件中搜索包含单词 "example" 的行
[root@hab1 /shell]# grep "example" demo.txt
Hello, this is an example file.
hello, this is an example file.
案例2:忽略大小写地搜索匹配模式的行
在文件中搜索不区分大小写的单词 "hello"的行
grep -i "hello" demo.txt

[root@hab1 /shell]# grep "Hello" demo.txt
Hello World!
Hello, this is an example file.
Hello, this is an Example file.
[root@hab1 /shell]# grep "hello" demo.txt
hello grep!
hello, this is an example file.
[root@hab1 /shell]# grep -i "hello" demo.txt
Hello World!
hello grep!
Hello, this is an example file.
Hello, this is an Example file.
hello, this is an example file.
[root@hab1 /shell]# grep -i "Hello" demo.txt
Hello World!
hello grep!
Hello, this is an example file.
Hello, this is an Example file.
hello, this is an example file.
[root@hab1 /shell]# grep "example" demo.txt
Hello, this is an example file.
hello, this is an example file.
[root@hab1 /shell]# grep -i "example" demo.txt
Hello, this is an example file.
Hello, this is an Example file.
hello, this is an example file.
案例3:反转匹配,只打印不匹配模式的行
在文件中搜索不包含"text"的行
grep -v "text" demo.txt
[root@hab1 /shell]# grep "text" demo.txt
It contains some lines of text.
[root@hab1 /shell]# grep -v "text" demo.txt
Hello World!
hello grep!
Hello, this is an example file.
Hello, this is an Example file.
hello, this is an example file.
Let's use grep to search for specific patterns.
案例4:显示匹配行的行号
在文件中搜索包含单词 "example" 的行,并显示行号
grep -n "example" demo.txt
[root@hab1 /shell]# grep "example" demo.txt
Hello, this is an example file.
hello, this is an example file.
[root@hab1 /shell]# grep -n "example" demo.txt
3:Hello, this is an example file.
6:hello, this is an example file.
案例5:统计匹配的行数
grep -c "example" demo.txt
[root@hab1 /shell]# grep -n "example" demo.txt
3:Hello, this is an example file.
6:hello, this is an example file.
[root@hab1 /shell]# grep -c "example" demo.txt
2
案例6:仅匹配整个单词
在文件中搜索包含单词 "example" 的行,是整个单词,而不是一个单词的一部分
echo example666 >> demo.txt
grep "example" demo.txt
grep -w "example" demo.txt

[root@hab1 /shell]# echo example666 >> demo.txt
[root@hab1 /shell]# cat demo.txt
Hello World!
hello grep!
Hello, this is an example file.
Hello, this is an Example file.
It contains some lines of text.
hello, this is an example file.
Let's use grep to search for specific patterns.
example666
[root@hab1 /shell]# grep "example" demo.txt
Hello, this is an example file.
hello, this is an example file.
example666
[root@hab1 /shell]# grep -w "example" demo.txt
Hello, this is an example file.
hello, this is an example file.
案例7:递归地搜索目录及其子目录下的文件
搜索/root/目录下包含内容"Hello, this is an example file."的所有文件
grep -r "Hello, this is an example file." /shell/
grep -r "example" /shell/

[root@hab1 /shell]# mkdir data
[root@hab1 /shell]# cp demo.txt data/demo123.txt
[root@hab1 /shell]# grep -r "Hello, this is an example file." /shell/
/shell/demo.txt:Hello, this is an example file.
/shell/data/demo123.txt:Hello, this is an example file.
三、Shell 三剑客之 sed 工具
作用:sed工具功能比较全,可以进行增删改查操作 => 运维工作中:修改操作相对而言是最多
1. sed 工具说明
我们都知道,Linux一切皆文件。比如配置文件,日志文件,启动文件等等。如果我们相对这些文件进行一些编辑查询等操作时,我们可能会想到一些vi,vim,cat,more等命令。但是这些命令效率不高,这就好比一块空地准备搭建房子,请了10个师傅拿着铁锹挖地基,花了一个月的时间才挖完,而另外一块空地则请了个挖土机,三下五除二就搞定了,这就是效率。而在Linux中的"挖土机"有三种型号:标配grep,中配sed,顶配awk。使用这些工具,我们能够在达到同样效果的前提下节省大量的重复性工作,提高效率。
sed 是Stream Editor(字符流编辑器)的缩写,简称流编辑器。什么是流?大家可以想象一下流水线,sed就像一个车间一样,文件中的每行字符都是原料,运到sed车间,然后经过一系列的加工处理,最后从流水线下来就变成货物了。

以前工厂中没有流水线时,生产一件商品需要十几个工种互相配合,这样下来效率太低,后来就有了流水线,生产一件商品虽然还是有十几道工序,但都是机器化生产,工人只是辅助作用,这样效率就大大提高了,产量也大大提高了。
编辑文件也是这样,以前我们修改一个配置文件,需要移动光标到某一行,然后添加点文字,然后又移动光标到另一行,注释点东西......可能修改一个配置文件下来需要花费数十分钟,还有可能改错了配置文件,又得返工。这还是一个配置文件,如果数十个数百个呢?因此当你学会了sed工具,你会发现利用它处理文件中的一系列修改是很有用的。只要想到在大约100多个文件中,处理20个不同的编辑操作可以在几分钟之内完成,你就会知道sed的强大了。
2. sed工具功能和版本
sed --version # 查看sed工具版本
3. 语法格式
sed [options] [sed -commands] [input -file]
sed   [选项]  【sed命令】 【输入文件】
说明:
① 注意sed工具以及后面选项,sed命令和输入文件,每个元素之间都至少有一个空格。
② 为了避免混淆,笔记中称呼sed为sed工具。sed -commands(sed命令)是sed工具内置的一些命令选项,为了和前面的options(选项)区分,故称为sed命令
③ sed -commands 既可以是单个sed命令,也可以是多个sed命令组合。
④ input -file (输入文件)是可选项,sed还能够从标准输入中,如管道中获取输入。
4. 命令执行流程
概括流程:sed工具从文件或管道中读取一行,处理一行,输出一行;再读取一行,再处理一行,再输出一行....
小知识:一次一行的设计使得sed工具性能很高,sed在读取非常庞大的文件时不会出现卡顿的想象。大家都用过vi/vim命令,用vi/vim命令打开几十M或更大的文件,会发现有卡顿现象,这是因为vi/vim命令打开文件是**一次性将文件加载到内存,然后再打开;**因此卡顿的时间长短就取决于从磁盘到内存的读取速度了。而且如果文件过大的话还会造成内存溢出现象。sed工具就很好的避免了这种情况,打开速度非常快,执行速度也很快。
详细流程:现有一个文件person.txt,共有五行文本,sed工具读入文件person.txt的第一行"101,Tom,CEO",并将这行文本存入模式空间(sed工具在内存中的一个临时缓存,用于存放读取到的内容,比喻为工厂流水线的传送带。)
文件person.txt在模式空间的完整处理流程
① 判断第1行是否是需要处理的行,如果是要处理的行,则接着往下走,如果不是要处理的行就重新从文件读取下一行
② 对模式空间的内容执行sed命令,比如a(append追加,在行之后),i(insert插入,在行之前),s(替换)...
③ 将模式空间中经过sed命令处理后的内容输出到屏幕上,然后清空模式空间
④ 读取下一行文本,然后重新执行上面的流程,直到文件结束

sed工具有两个内置的存储空间:
☆ 模式空间(pattern space):是sed工具从文本读取一行文本然后存入的缓冲区(这个缓冲区是在内存中的),然后使用sed命令操作模式空间的内容。
☆ 保持空间(hold space):是sed工具另外一个缓冲区,用来存放临时数据,也是在内存中,但是模式空间和保持空间的用途是不一样的。sed可以交换保持空间和模式空间的数据,但是不能在保持空间上执行普通的sed命令,也就是说我们可以在保持空间存储数据。
5. sed 选项说明
sed 选项 sed命令 文件
| option[选项] | 解释说明(带*的为重点) |
|---|---|
| -n | 取消默认的sed工具的输出,常与sed命令的p连用* |
| -r | 使用扩展正则表达式(grep -E),默认情况sed只识别基本正则表达式* |
| -i | 直接修改文件内容,而不是输出到终端,如果不使用-i选项,sed工具只是修改在内存中的数据,并不会影响磁盘上的文件* |
| sed -commands | 解释说明(带*的为重点) |
|---|---|
| a | append追加,在指定行后添加一行或多行文本* |
| c | change,取代指定的行 |
| d | delete,删除指定的行* |
| i | insert插入,在指定行前添加一行或多行文本* |
| p | print,打印模式空间内容,通常p会与选项-n一起使用* |
| q | 退出sed |
| r | 从指定文件读取数据 |
| s | 取代,s#old#new#g==>这里g是s命令的替代标志* |
重点记住:增删改查操作 => 增加a、删除d、修改c或s、查询p
| 特殊符号 | 解释说明(带*的为重点) |
|---|---|
| ! | (取反),对指定行以外的所有行应用命令* |
| = | 打印当前行行号 |
| ~ | "first ~ step"表示从first行开始,以步长step递增 |
6. sed 增加操作
数据集准备
cat >person.txt<<EOF
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
EOF
互联网/企业最常用 C×O 一览表,包含全称、中文及核心职责。
| 缩写 | 英文全称 | 中文 | 核心职责 |
|---|---|---|---|
| CEO | Chief Executive Officer | 首席执行官 | 企业最高负责人,制定战略、全面决策 |
| COO | Chief Operating Officer | 首席运营官 | 负责日常运营、管理执行、流程优化 |
| CTO | Chief Technology Officer | 首席技术官 | 技术研发、架构设计、技术战略 |
| CFO | Chief Financial Officer | 首席财务官 | 财务管理、融资、预算、风险控制 |
| CIO | Chief Information Officer | 首席信息官 | IT系统、信息化建设、数据管理 |
| CSO | Chief Security Officer | 首席安全官 | 网络安全、数据安全、合规风控 |
| CSO | Chief Strategy Officer | 首席战略官 | 战略规划、投资并购、业务拓展 |
| CMO | Chief Marketing Officer | 首席营销官 | 市场品牌、营销推广、用户增长 |
| CHO | Chief Human Resources Officer | 首席人力资源官 | 人力资源、组织发展、企业文化 |
| CPO | Chief Product Officer | 首席产品官 | 产品规划、设计、生命周期管理 |
| CLO | Chief Legal Officer | 首席法务官 | 法律事务、合规、合同、知识产权 |
| CDO | Chief Data Officer | 首席数据官 | 数据治理、大数据分析、数据驱动决策 |
记忆规律
- C = Chief(首席)
- O = Officer(官)
- 中间字母 = 负责领域(E=执行,O=运营,T=技术,F=财务,I=信息,S=安全/战略,M=市场,H=人力,P=产品,L=法律,D=数据)
补充:部分企业还会设置 CKO(首席知识官)、CRO(首席风险官)等,以上为最常用的 11 个核心职位。
增加操作就是往文件指定位置追加或插入指定文本。
这个功能非常有用,比如我们平时往配置文件写入几行文本,最常用的是vi或vim命令,但是这2个命令是一种交互式的命令,还需要我们在vi/vim编辑器界面输入字符串然后保存退出,操作有些繁琐但是还能用。但是当我们学会了Shell脚本后,我们就会发现在脚本中不能正常使用vi或vim命令,为什么呢?
我们学习Shell脚本主要是为了解放我们的双手,执行一个脚本,然后自动往文件中写入数据,不需要我们再动手。因此我们想到了sed工具,它能够帮助我们实现目的。
这里我们需要用到2个sed命令,分别是:
"a" : 追加文本到指定行后,记忆方法:a的全拼是apend,意思是追加。
"i" :插入文本到指定行前,记忆方法:i的全拼是insert,意思是插入。
单行增加:
首先我们看一下单行增加的用法,说白了就是在文件中增加一行文本,我们以前学过echo命令可以在文件的末尾追加文本,比较简单,但是我们还有其他的复杂需求,比如在第10行插入一行数字等等,这里就需要sed出马了。我们来看一下面的例子:
sed '2a 106,Smith,CSO' person.txt

注:
2代表指定对第2行操作,其他的行忽略;
a代表追加的意思,2a即在第2行后追加文本;
2a后面加上空格,然后跟上你想要插入的多行文本即可。这里的每行文本使用"\n"连接就可以写成一行了。
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '2a 106,Smith,CSO' person.txt
101,Tom,CEO
102,Rose,CTO
106,Smith,CSO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '2i 106,Smith,CSO' person.txt
101,Tom,CEO
106,Smith,CSO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed -i '2i 106,Smith,CSO' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
106,Smith,CSO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed -i '2a 106,Smith,CSO' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
106,Smith,CSO
106,Smith,CSO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
多行增加:
sed '2a 106,Eric,CSO\n107,Susan,CCO' person.txt
注:\n代表换行符
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '2a 106,Eric,CSO\n107,Susan,CCO' person.txt
101,Tom,CEO
102,Rose,CTO
106,Eric,CSO
107,Susan,CCO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed -i '2a 106,Eric,CSO\n107,Susan,CCO' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
106,Eric,CSO
107,Susan,CCO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
首行和尾行增加:
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '$a 106,Smith,CSO' person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Smith,CSO
[root@hab1 /shell]# sed '1i 106,Smith,CSO' person.txt
106,Smith,CSO
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
小结:
sed默认操作文件内容是在内存中的模式空间中进行实现,不会影响原文件内容。
增加操作有两种方式(行号 + i,指定行前面添加内容),(行号 + a,指定行后面添加内容)
如果希望增加操作影响原文件,可以添加一个选项-i
7. sed 删除操作
删除指定行文本。
这个功能也是非常得有用,比如我们想删除文件中的某些行,以前最常用的是vi或vim命令,但现在我们知道了sed命令,就应该使用这个高逼格的命令完成任务了。
这里我们需要用到1个sed命令。
"d":删除文本,记忆方法:d的全称是delete,意思是删除。
因为删除功能比较简单,因此我们结合地址范围一起说明。我们前面学过sed命令可以对一行文本为目标进行处理(在单行前后增加一行或多行文本),接下来我们看一下如何对多行文本为目标操作。
指定执行的地址范围:
sed工具可以对单行或多行文本进行处理。如果在sed命令前面不指定地址范围,那么默认会匹配所有行。
用法:n1[,n2]{sed -commands}
地址用逗号分隔开,n1,n2可以用数字,正则表达式,或者二者的组合表示。
| 地址范围 | 含义 |
|---|---|
| 10 | 对第10行操作 |
| 10,20 | 对10到20行操作,包括第10,20行 |
| 1~2 | first~step,对1,3,5,7.....行操作 |
| 10,$ | 对10到最后一行($代表最后一行)操作,包括第10行 |
| /Tom/ | 对匹配Tom的行操作 |
| /Tom/,/Alex/ | 对匹配Tom的行到匹配Alex的行操作 |
| /Tom/,$ | 对匹配Tom的行到最后一行操作 |
| 1,/Alex/ | 对第1行到匹配Alex的行操作 |
案例1-3:下面用具体的例子演示一下sed删除操作实现
sed 'd' person.txt
命令说明:如果在sed命令前面不指定地址范围,那么默认会匹配所有行,然后使用d命令删除功能就会删除这个文件的所有内容
sed '2d' person.txt
命令说明:这个单行删除想必大家能理解,指定删除第2行的文本
sed '2,5d' person.txt
命令说明:'2,5d' 指定删除第2行到第5行的内容,d代表删除操作。
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed 'd' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '2d' person.txt
101,Tom,CEO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed -i '2d' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO

[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '2,5d' person.txt
101,Tom,CEO
[root@hab1 /shell]# sed '2,3d' person.txt
101,Tom,CEO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '4,5d' person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed -i '2,5d' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
案例4:
sed '/Jack/d' person.txt
命令说明:在sed工具中,使用正则的格式和awk一样,使用2个"/"包含指定的正则表达式,即"/正则表达式/"。
[root@hab1 /shell]# vim person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '/Jack/d' person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
105,Jennifer,CIO
[root@hab1 /shell]# sed '/Tom/d' person.txt
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '/105/d' person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed -i '/105/d' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
案例5:
sed '/Tom/,/Alex/d' person.txt
命令说明:这是正则表达式形式的多行删除,也是以逗号分隔2个地址,最后结果是删除包含"Tom"的行到包含"Alex"的行
[root@hab1 /shell]# vim person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '/Tom/,/Alex/d' person.txt
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '/103/,/105/d' person.txt
101,Tom,CEO
102,Rose,CTO
[root@hab1 /shell]# sed -i '/103/,/105/d' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
案例6:
sed '3,$d' person.txt
命令说明:学过正则表达式后我们知道"$"代表行尾,但是在sed中就有一些变化了,"$"在sed中代表文件的最后一行。因此本例子的含义是删除第3行到最后一行的文本,包含第3行和最后一行,因此剩下第1,2行的内容。
[root@hab1 /shell]# vim person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '3,$d' person.txt
101,Tom,CEO
102,Rose,CTO
[root@hab1 /shell]# sed -i '3,$d' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
案例7:
sed '$a 106,Tom,CSO' person.txt
命令说明:该命令会读取 person.txt 文件内容,在内存中进行临时修改(在最后一行追加内容),然后将修改后的结果输出到屏幕,不会修改原始文件 person.txt,属于安全的 “预览式修改”。
[root@hab1 /shell]# vim person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '$a 106,Tom,CSO' person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed -i '$a 106,Tom,CSO' person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
案例8:
特殊符号~(步长)解析
格式:"first~step"表示从开始,以步长step递增,这个在数学中叫做等差数列
使用:
1~2 匹配1,3,5,7...     #-->用于只输出奇书行,大伙仔细观察一下每个数字的差值。
2~2 匹配2,4,6,8...     #-->用于只输出偶数行
1~3 匹配1,4,7,10...
2~3 匹配2,5,8,11...
[root@hab1 /shell]# seq 10
1
2
3
4
5
6
7
8
9
10
[root@hab1 /shell]# seq 10 | sed -n '1~2p'
1
3
5
7
9
[root@hab1 /shell]# seq 10 | sed -n '1~3p'
1
4
7
10
[root@hab1 /shell]# seq 10 | sed -n '2~3p'
2
5
8
[root@hab1 /shell]# seq 10 | sed -n '2~2p'
2
4
6
8
10
命令说明:
-n 关闭默认的输出 -p 打印现有规则的输出
上面的命令主要验证特殊符号"~"的效果,其他sed命令用法n和p请见后文详解,大家只需要知道这个命令可以将"1~2"指定的行显示出来即可。
上面例子测试了"1~2"的效果,大家也可以手动测试一下"2~2","1~3","2~3",看一下他们的结果是不是符合等差数列。
案例9:删除所有奇数行
sed '1~2d' person.txt
命令说明:"1~2"这是指定行数的另一种格式,从第1行开始以步长2递增的行(1,3,5),因此删掉第1,3,5行,即所有的奇数行。
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed '1~2d' person.txt
102,Rose,CTO
104,Jack,CFO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
[root@hab1 /shell]# sed -i '1~2d' person.txt
[root@hab1 /shell]# cat person.txt
102,Rose,CTO
104,Jack,CFO
案例10: 特殊符号!
感叹号 "!" 我们在很多命令里都接触过,大部分都是取反的意思,在sed中也不例外。
sed '2,3!d' person.txt
命令说明:在地址范围"2,3"后面加上"
!",如果不加"!"表示删除第2行和第3行,结果如下面的例子所示,然后加上"!"的结果就是除了第2行和第3行以外的内容都删除,这个方法可以作为显示文件的第2,3行题目的补充方法。
[root@hab1 /shell]# vim person.txt
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /shell]# sed '2,3!d' person.txt
102,Rose,CTO
103,Alex,COO
[root@hab1 /shell]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /shell]# sed -i '2,3!d' person.txt
[root@hab1 /shell]# cat person.txt
102,Rose,CTO
103,Alex,COO
小结:
sed工具不仅可以添加数据行,也可以删除数据行,删除数据行必须使用(d)命令
sed删除 => (sed '范围d' 文件)=> 默认都是在内存中完成,需要影响原文件,则添加一个-i
8. sed 修改操作(重点)
sed修改操作,我们最常见的操作就是改配置文件,改参数等等 首先说一下按行替换,这个功能用的很少,所以大家了解即可。这里用到的sed命令是:"c":用新行取代旧行,记忆方法:c的全拼是change,意思是替换。
sed '2c 106,Smith,CSO' person.txt
命令说明:使用sed命令c将原来第2行内容替换成106,Smith,CSO,整行替换
[root@hab1 /data]# vim person.txt
[root@hab1 /data]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /data]# sed '2c 666' person.txt
101,Tom,CEO
666
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /data]#
[root@hab1 /data]# sed '2c 102,hab,CFO' person.txt
101,Tom,CEO
102,hab,CFO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /data]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /data]# sed -i '2c 102,hab,CFO' person.txt
[root@hab1 /data]# cat person.txt
101,Tom,CEO
102,hab,CFO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
☆ 关键词替换
接下来说的这个功能,有工作经验的同学应该非常的熟悉,因为使用sed工具80%的场景就是使用替换功能。
这里用到的sed命令,选项:
"s":单独使用-->将每一行中第一处匹配的字符串进行替换-->sed命令
"g":每一行进行全部替换-->sed命令s的替换标志之一(全局替换),非sed命令
"-i":修改文件内容-->sed工具的选项,注意和sed命令i区别
sed工具替换模型
sed -i 's/旧的内容/替换后内容/' 文件内容
sed -i 's/旧的内容/替换后内容/g' 文件内容
sed -i 's#旧的内容#替换后内容#g' 文件内容

路径替换式
s#/home#/root#g

g:global全局替换
sed本身按照行操作的,如果在1行中有多个要替换的关键词,不加g,则代表只替换满足条件第一个关键词;如果添加g,则代表替换满足条件的所有关键词!
特点:
- 两边是引号,引号里面的两边分别为s和g,中间是三个一样的字符/或#作为定界符。字符#能在替换内容包含字符/有助于区别。定界符可以是任意字符如:或|等,但当替换内容包含定界符时,需要转义\:或|。经过长期实践,建议大家使用#作为定界符。
- 定界符/或#,第一个和第二个之间的就是被替换的内容,第二个和第三个之间的就是替换后的内容。
- s#目标内容#替换内容#g ,"目标内容"能用正则表达式,但替换内容不能用,必须是具体的。因为替换内容使用正则的话会让sed工具无所适从,它不知道你要替换什么内容。
- 默认sed工具是对模式空间(内存中的数据)操作,而-i选项会更改磁盘上的文件内容。
案例1:
sed 's#Tom#Eric#g' person.txt

命令说明:将需要替换的文本"Tom"放在第一个和第二个"#"之间,将替换后的文本"Eric"放在第二个核第三个"#"之间。结果为第二行的"Tom"替换为"Eric"。
[root@hab1 /data]# cat person.txt
101,Tom,CEO
102,hab,CFO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /data]# sed 's#Tom#Hab#g' person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
[root@hab1 /data]# cat person.txt
101,Tom,CEO
102,hab,CFO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Tom,CSO
[root@hab1 /data]# sed -i 's#Tom#Hab#g' person.txt
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
案例2:指定行修改配置文件
sed '3s#0#6#' person.txt

命令说明:前面学习的例子在sed命令"s"前没有指定地址范围,因此默认是对所有行进行操作。而这个案例要求只将第3行的0换成6,这里就用到了我们前面学过的地址范围知识,在sed命令"s"前加上"3"就代表对第3行进行替换
[root@hab1 /data]# sed '3s#COO#CGO#g' person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,COO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
[root@hab1 /data]# sed -i '3s#COO#CGO#g' person.txt
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
分组替换() 和 \1的使用功能(难点)
sed工具的()的功能可以记住正则表达式的一部分,
其中,\1为第一个记住的模式即第一个小括号中的匹配内容,
\2第二个记住的模式,即第二个小括号中的匹配内容,
sed最多可以记住9个。
案例1:执行命令取出Linux中的 ens160 的IP地址
[root@hab1 /data]# ifconfig ens160 | sed -n '2p'
        inet 192.168.80.11  netmask 255.255.255.0  broadcast 192.168.80.255
[root@hab1 /data]# ifconfig ens160 | sed -n '2p' | sed -r 's#.*inet ([0-9.]+).*#\1#g'
192.168.80.11

命令说明:
ifconfig ens160:查看网卡ens160的网络信息
sed -n '2p':只输出第 2 行内容(IP 地址所在行)
sed -r:启用扩展正则表达式
s###g:替换语法,#是分隔符
.*inet ([0-9.]+).*:匹配整行,捕获inet 后的 IP 地址为分组 1
\1:引用第 1 个捕获分组的内容
结果:精准提取并输出网卡的 IP 地址 192.168.80.11
ip a 拓展
# 显示ens160网卡信息 | 筛选含inet的行 | 打印第2列 | 按/分割取第一段
[root@hab1 /data]# ip a show ens160 | awk '/inet /{print $2}' | cut -d/ -f1
192.168.80.11
# 显示网卡信息 | 只保留含inet的行 | 正则提取纯IP地址
[root@hab1 /data]# ip a show ens160 | sed -n '/inet /p' | sed -r 's#.*inet ([0-9.]+)/.*#\1#g'
192.168.80.11
逐段带注释
ip a show ens160   # 只查看 ens160 网卡的详细信息
|                  # 管道:把前一个命令结果传给下一个
awk '/inet /{print $2}'  # 筛选包含 inet 的行,输出该行第 2 个字段(IP/掩码 格式)
|                  # 管道继续传递
cut -d/ -f1        # 按 / 分割字符串,取第 1 段(纯IP)
ip a show ens160          # 查看 ens160 网卡信息
|                         # 管道传递结果
sed -n '/inet /p'         # -n 静默输出,只打印匹配 inet 的那一行
|                         # 管道传递
sed -r 's#.*inet ([0-9.]+)/.*#\1#g'  # 正则替换:提取括号内的IP地址,去掉掩码
最简总结
- 两条命令功能完全一样:输出
192.168.80.11 - 第二条最贴合原来的写法:结构、复杂度、风格 1:1 对应
- 注释版方便学习、记忆、写脚本
案例2:从文本中提取名字
[root@hab1 /data]# echo "I am eric teacher." | sed -r 's#^.*am ([a-z]+) tea.*$#\1#g'
eric

命令说明:
sed -r:启用扩展正则表达式,括号()无需转义
s###g:替换语法,#是分隔符,g表示全局替换
^.*am ([a-z]+) tea.*$:匹配整行内容,并将am与tea之间的小写字母单词捕获为分组 1
\1:引用第 1 个捕获分组的内容
结果:把整行替换为捕获的单词,只输出 eric
分组替换详细解析
一、核心概念(优化版描述)
在 sed 中,小括号 () 的作用是分组(捕获),可以把正则表达式中匹配到的某一部分“记住”。
- 第 1 个括号 →
\1 - 第 2 个括号 →
\2 - …
- 最多支持到
\9
本质就是: 先匹配 → 再通过 \1、\2 把匹配到的内容拿出来用(通常用于替换)
注意:
- 使用
-r(或-E)时:()可以直接用 - 不加时:要写成
\(\)
二、案例1解析(提取 IP)
原始命令
ifconfig ens160 | sed -n '2p' | sed -r 's#.*inet ([0-9.]+).*#\1#g'
第一步
[root@hab1 /data]# ifconfig ens160 | sed -n '2p'
        inet 192.168.80.11  netmask 255.255.255.0  broadcast 192.168.80.255
第二步(重点)
[root@hab1 /data]# ifconfig ens160 | sed -n '2p' | sed -r 's#.*inet ([0-9.]+).*#\1#g'
192.168.80.11
正则拆解
.*inet ([0-9.]+).*
.*→ 任意内容(吃掉前面所有)inet→ 定位关键字([0-9.]+)→ 捕获 IP 地址.*→ 吃掉后面所有
实际匹配过程:
inet 192.168.88.100 ...
     ↑这里被括号记住
替换部分
\1
把整行替换成:
第1个分组(IP地址)
最终结果
192.168.80.11
本质一句话总结: 整行匹配 → 只保留括号里那一段
三、案例2解析(提取名字)
原始命令
echo "I am eric teacher." | sed -r 's#^.*am ([a-z]+) tea.*$#\1#g'

[root@hab1 /data]# echo "I am eric teacher." | sed -r 's#^.*am ([a-z]+) tea.*$#\1#g'
eric
正则拆解
^.*am ([a-z]+) tea.*$
^→ 行开头.*am→ 匹配到 am([a-z]+)→ 捕获名字(eric)tea→ 限定后面是 tea(teacher).*$→ 吃掉剩余内容
匹配过程
I am eric teacher.
     ↑这里被捕获
替换
\1
整行变成:
eric
四、两个案例的共同本质(重点)
这两个命令其实做的是同一件事:
sed 's#整行匹配(你要的部分)整行匹配#\1#g'
核心思想:
- 用
.*把无关内容“吃掉” - 用
()精准抓住目标 - 用
\1输出目标
9. sed 查询操作
这个功能也是非常得有用,比如我们想查看文件中的某些行,以前最常用的是cat或more或less命令等,但这些命令有些缺点,就是不能查看指定的行。而我们用了很久的sed命令就有了这个功能了。而且我们前面也说过使用sed比其他命令vim等读取速度更快!
这里我们需要用到1个sed命令
"p":输出指定内容,但默认会输出2次匹配的结果,因此使用-n选项取消默认输出,记忆方法:p的全拼是print,意思是打印。
案例1:
sed '2p' person.txt
命令说明:选项-n取消默认输出,只输出匹配的文本,大家只需要记住使用命令p必用选项-n。

sed -n '2p' person.txt
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
[root@hab1 /data]# sed '2p' person.txt
101,Hab,CEO
102,hab,CFO
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
[root@hab1 /data]# sed -n '2p' person.txt
102,hab,CFO
案例2:
sed -n '2,3p' person.txt
命令说明:查看文件的第2行到3行,使用地址范围"2,3"。取行就用sed,最简单
[root@hab1 /data]# sed -n '2,3p' person.txt
102,hab,CFO
103,Alex,CGO
[root@hab1 /data]# sed -n '2,5p' person.txt
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
案例3:
sed -n '1~2p' person.txt
注意:起始值~步长
命令说明:打印文件的1,3,5行,~代表步长
[root@hab1 /data]# sed -n '1~3p' person.txt
101,Hab,CEO
104,Jack,CFO
[root@hab1 /data]# sed -n '1~2p' person.txt
101,Hab,CEO
103,Alex,CGO
105,Jennifer,CIO
案例4:
sed -n 'p' person.txt
命令说明:不指定地址范围,默认打印全部内容。
[root@hab1 /data]# sed -n 'p' person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
[root@hab1 /data]# sed  'p' person.txt
101,Hab,CEO
101,Hab,CEO
102,hab,CFO
102,hab,CFO
103,Alex,CGO
103,Alex,CGO
104,Jack,CFO
104,Jack,CFO
105,Jennifer,CIO
105,Jennifer,CIO
106,Hab,CSO
106,Hab,CSO
案例5:
sed -n '/CTO/p' person.txt
命令说明:打印含CTO的行
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
[root@hab1 /data]# sed -n '/CEO/p' person.txt
101,Hab,CEO
[root@hab1 /data]# sed -n '/hab/p' person.txt
102,hab,CFO
[root@hab1 /data]# sed -n '/106/p' person.txt
106,Hab,CSO
案例6:
sed -n '/CTO/,/CFO/p' person.txt
命令说明:打印含CTO的行到含CFO的行
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
106,Hab,CSO
[root@hab1 /data]# sed -n '/CEO/,/CIO/p' person.txt
101,Hab,CEO
102,hab,CFO
103,Alex,CGO
104,Jack,CFO
105,Jennifer,CIO
案例7:
sed -i.bak 's#Tom#Peter#g' person.txt
命令说明:
在-i参数的后边加上.bak(.任意字符),sed会对文件进行先备份后修改
[root@hab1 /data]# vim person.txt
[root@hab1 /data]# cat person.txt
101,Tom,CEO
102,Rose,CTO
103,Smith,CSO
104,Jack,CFO
105,Jennifer,CIO
106,Eric,CSO
[root@hab1 /data]# ll person.txt .bak
ls: 无法访问 '.bak': 没有那个文件或目录
-rw-r--r-- 1 root root 82  4月 13 11:00 person.txt
[root@hab1 /data]# sed -i.bak 's#Tom#Hab#g' person.txt
[root@hab1 /data]# ll person.txt.bak
-rw-r--r-- 1 root root 82  4月 13 11:00 person.txt.bak
[root@hab1 /data]# cat person.txt.bak
101,Tom,CEO
102,Rose,CTO
103,Smith,CSO
104,Jack,CFO
105,Jennifer,CIO
106,Eric,CSO
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,Rose,CTO
103,Smith,CSO
104,Jack,CFO
105,Jennifer,CIO
106,Eric,CSO
案例8:
特殊符号 = 获取行号(了解)
sed '=' person.txt
命令说明:使用特殊符号 = 就可以获取文件的行号,这是特殊用法,记住即可。从上面的命令结果我们也发现了一个不好的地方:行号和行不在一行。
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,Rose,CTO
103,Smith,CSO
104,Jack,CFO
105,Jennifer,CIO
106,Eric,CSO
[root@hab1 /data]# sed '=' person.txt
1
101,Hab,CEO
2
102,Rose,CTO
3
103,Smith,CSO
4
104,Jack,CFO
5
105,Jennifer,CIO
6
106,Eric,CSO
案例9:
sed '1,3=' person.txt
命令说明:打印1,2,3行的行号,同时打印输出文件中的内容
[root@hab1 /data]# sed '1,3=' person.txt
1
101,Hab,CEO
2
102,Rose,CTO
3
103,Smith,CSO
104,Jack,CFO
105,Jennifer,CIO
106,Eric,CSO
[root@hab1 /data]# sed '3,5=' person.txt
101,Hab,CEO
102,Rose,CTO
3
103,Smith,CSO
4
104,Jack,CFO
5
105,Jennifer,CIO
106,Eric,CSO
案例10:取不连续的行
sed -n '1p;3p;5p' person.txt
[root@hab1 /data]# cat person.txt
101,Hab,CEO
102,Rose,CTO
103,Smith,CSO
104,Jack,CFO
105,Jennifer,CIO
106,Eric,CSO
[root@hab1 /data]# sed -n '1p;3p;5p' person.txt
101,Hab,CEO
103,Smith,CSO
105,Jennifer,CIO
小结:
sed如果想对行进行打印输出,通常使用(p)命令,取消默认输出,使用选项(-n)
sed功能非常强大:支持(增删改查操作)
四、Shell 三剑客之 awk 工具
作用:awk可以完成复杂的数据分析,如Linux系统关键信息提取、指定文本内容提取、日志分析等等。
1. awk 概述
awk不仅仅是Linux系统中的一个命令,更可以理解为它是一种编程语言,可以用来处理数据和生成报告(excel)。处理的数据可以是一个或多个文件,可以是来自标准输入,也可以通过管道获取标准输入,awk可以在命令行上直接编辑命令进行操作,也可以编写成awk程序来进行更为复杂的运用。
2. awk 四大核心分隔符 RS FS ORS OFS
awk 四大核心分隔符
1. RS 输入记录分隔符
作用:决定 awk 怎么“切行”
- 读数据时,遇到什么符号才算一行结束
- 默认:
\n(换行符) - 你可以改成:
/``,``空格等
大白话:你告诉 awk:看到这个符号,就当是上一行结束!
2. ORS 输出记录分隔符
作用:决定 awk 打印时,行与行之间用什么隔开
- 输出每一行后,自动加的符号
- 默认:
\n(换行)
大白话:你让 awk 每打印完一段,就加这个符号!
3. FS 输入字段分隔符
作用:决定 awk 怎么“切列”
- 把一行切成多个列(1 2 $3...)
- 默认:一个或多个空格、Tab
大白话:你告诉 awk:看到这个符号,就当是一列结束!
4. OFS 输出字段分隔符
作用:决定 print 打印多列时,用什么连接它们
print $1,$2中间自动加的符号- 默认:空格
大白话:你让 awk 打印多列时,列和列之间用这个符号连起来!
超级好记总结(4 句话背会)
- RS:输入时,怎么切行
- ORS:输出时,行之间用什么分开
- FS:输入时,怎么切列
- OFS:输出时,列之间用什么分开
最精简黄金口诀
输入看 RS、FS
输出看 ORS、OFS
| 变量 | 全称 | 方向 | 作用(一句话) | 默认值 |
|---|---|---|---|---|
| RS | Record Separator | 输入 | 读取时:怎么切行 | \n |
| ORS | Output Record Separator | 输出 | 输出时:行尾加什么 | \n |
| FS | Field Separator | 输入 | 读取时:怎么切列 | 空格 / Tab |
| OFS | Output Field Separator | 输出 | 输出时:列间用什么 | 空格 |

3. awk 格式
awk指令是由模式,动作,或者模式和动作的组合组成。
模式既pattern,可以类似理解成sed的模式匹配,可以由表达式组成,也可以是两个正斜杠之间的正则表达式。比如NR==1,这就是模式,可以把他理解为一个条件。
动作即action,是由在大括号里面的一条或多条语句组成,语句之间使用分号隔开。

awk处理的内容可以来自标准输入(<),一个或多个文本文件或管道。

options既参数,使用最多的参数为-F(Field,用于指定字段与字段之间的分隔符,列与列之间的分隔符,默认为空格)
pattern既模式,也可以理解为条件,也叫找谁,你找谁?高矮,胖瘦,男女?都是条件,既模式。
action既动作,可以理解为干啥,找到人之后你要做什么。
格式:awk -F"分隔符" '模式和动作' file
模式和动作的详细介绍我们放在后面部分,现在大家先对awk结构有一个了解。
案例1:基本模式与动作
[root@hab1 /data]# awk -F ":" 'NR>=2 && NR<=6 {print NR,$1}' /etc/passwd
2 bin
3 daemon
4 adm
5 lp
6 sync

命令说明:
-F 指定分隔符为冒号,相当于以“:”为菜刀,进行字段的切割。
NR>=2 && NR<=6:这部分表示模式,是一个条件,表示取第2行到第6行。
{print NR,$1}:这部分表示动作,表示要输出NR行号和$1第一列。
NR == Number(数字、号码)+ Record(记录、行)== 行号
[root@hab1 /data]# head /etc/passwd
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
sync:x:5:0:sync:/sbin:/bin/sync
shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
halt:x:7:0:halt:/sbin:/sbin/halt
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
operator:x:11:0:operator:/root:/sbin/nologin
[root@hab1 /data]# awk -F ":" 'NR>=2 && NR<=6 {print NR,$1}' /etc/passwd
2 bin
3 daemon
4 adm
5 lp
6 sync
[root@hab1 /data]# awk -F ":" 'NR>=2 && NR<=6 {print $1}' /etc/passwd
bin
daemon
adm
lp
sync
[root@hab1 /data]# awk -F ":" 'NR>=1 && NR<=3 {print NR,$1}' /etc/passwd
1 root
2 bin
3 daemon
[root@hab1 /data]# awk -F ":" 'NR>=1 && NR<=3 {print NR,$2}' /etc/passwd
1 x
2 x
3 x
[root@hab1 /data]# awk -F ":" 'NR>=1 && NR<=3 {print NR,$3}' /etc/passwd
1 0
2 1
3 2
案例2:只有模式
[root@hab1 /data]# awk -F ":" 'NR>=1 && NR<=3' /etc/passwd
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin

命令说明:
-F指定分隔符为冒号
NR>=2&&NR<=6这部分是条件,表示取第2行到第6行。
但是这里没有动作,这里大家需要了解如果只有条件(模式)没有动作,awk默认输出整行
案例3:只有动作
[root@hab1 /data]# awk -F ":" '{print NR,$1}' /etc/passwd | head
1 root
2 bin
3 daemon
4 adm
5 lp
6 sync
7 shutdown
8 halt
9 mail
10 operator

命令说明:
-F指定分隔符为冒号
这里没有条件,表示对每一行都处理
{print NR,$1}表示动作,显示NR行号与$1第一列
这里要理解没有条件的时候,awk会处理每一行。
案例4:多模式与多动作
[root@hab1 /data]# awk -F ":" 'NR==1{print NR,$1}NR==2{print NR,$NF}' /etc/passwd
1 root
2 /sbin/nologin

命令说明:
-F指定分隔符为冒号
这里有多个条件与动作的组合
NR==1表示条件,行号(NR)等于1的条件满足的时候,执行{print NR,$1}动作,输出行号与第一列。
NR==2表示条件,行号(NR)等于2的条件满足的时候,执行{print NR,$NF}动作,输出行号与最后一列($NF)
[root@hab1 /data]# head /etc/passwd
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
sync:x:5:0:sync:/sbin:/bin/sync
shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
halt:x:7:0:halt:/sbin:/sbin/halt
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
operator:x:11:0:operator:/root:/sbin/nologin
[root@hab1 /data]# awk -F ":" 'NR==1{print NR,$1}NR==2{print NR,$NF}' /etc/passwd
1 root
2 /sbin/nologin
[root@hab1 /data]# awk -F ":" 'NR==1{print NR,$NF}NR==2{print NR,$NF}' /etc/passwd
1 /bin/bash
2 /sbin/nologin
[root@hab1 /data]# awk -F ":" 'NR==1{print NR,$NF}NR==2{print NR,$3}' /etc/passwd
1 /bin/bash
2 1
NR:Number Record,行号信息
NF:Number Field,注意:计数情况下,往往都代表最后一个,所以NF代表最后一列
注意:
Pattern和{Action}需要用单引号引起来,防止Shell作解释。
Pattern是可选的。如果不指定,awk将处理输入文件中的所有记录。如果指定一个模式,awk则只处理匹配指定的模式的记录。
{Action}为awk命令,可以是但个命令,也可以多个命令。整个Action(包括里面的所有命令)都必须放在{ 和 }之间。
Action必须被{ }包裹,没有被{ }包裹的就是Pattern
file要处理的目标文件
4. awk 执行过程
创建测试文件及内容
[root@hab1 /root]# mkdir -p /server/files
[root@hab1 /root]# head /etc/passwd >/server/files/awkfile.txt
[root@hab1 /root]# cat /server/files/awkfile.txt
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
sync:x:5:0:sync:/sbin:/bin/sync
shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
halt:x:7:0:halt:/sbin:/sbin/halt
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
operator:x:11:0:operator:/root:/sbin/nologin
在深入了解 awk 前,我们需要知道 awk 如何处理文件的。
awk执行过程演示:
[root@hab1 /root]# awk 'NR>=2{print $0}' /server/files/awkfile.txt
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
sync:x:5:0:sync:/sbin:/bin/sync
shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
halt:x:7:0:halt:/sbin:/sbin/halt
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
operator:x:11:0:operator:/root:/sbin/nologin

命令说明:
条件NR>=2,表示行号大于等于2时候,执行{print $0}显示整行。
awk是通过一行一行的处理文件,这条命令中包含模式部分(条件)和动作部分(动作),awk将处理模式(条件)指定的行

$0代表所有列,$1代表第1列,$2代表第2列,... $NF代表最后1列
[root@hab1 /root]# cat /server/files/awkfile.txt
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
sync:x:5:0:sync:/sbin:/bin/sync
shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
halt:x:7:0:halt:/sbin:/sbin/halt
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
operator:x:11:0:operator:/root:/sbin/nologin

[root@hab1 /root]# awk 'NR>=2&&NR<=5{print $0}' /server/files/awkfile.txt
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
[root@hab1 /root]# awk 'NR>=2&&NR<=5{print $1}' /server/files/awkfile.txt
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
[root@hab1 /root]# awk 'NR>=2&&NR<=5{print $2}' /server/files/awkfile.txt


[root@hab1 /root]# awk 'NR>=2&&NR<=5{print $3}' /server/files/awkfile.txt


[root@hab1 /root]# awk -F ":" 'NR>=2&&NR<=5{print $1}' /server/files/awkfile.txt
bin
daemon
adm
lp
[root@hab1 /root]# awk -F ":" 'NR>=2&&NR<=5{print $2}' /server/files/awkfile.txt
x
x
x
x
[root@hab1 /root]# awk -F ":" 'NR>=2&&NR<=5{print $3}' /server/files/awkfile.txt
1
2
3
4
[root@hab1 /root]# awk -F ":" 'NR>=2&&NR<=5{print $NF}' /server/files/awkfile.txt
/sbin/nologin
/sbin/nologin
/sbin/nologin
/sbin/nologin
awk执行过程解析:
① awk读入第一行内容
② 判断是否符合模式中的条件NR>=2
如果匹配则执行对应的动作{print $0}
如果不匹配条件,继续读取下一行
③ 继续读取下一行
④ 重复过程1-3,直到读取到最后一行(EOF:end of file)

5. awk 记录(行)
记录和字段 接下来我给大家带来两个新概念记录和字段,这里为了方便大家理解可以把记录就当作行即记录==行,字段相当于列,字段==列。
| 名称 | 含义 |
|---|---|
| record | 记录,行 => NR(Number Record)行号 |
| field | 域,区域,字段,列 => NF(Number Field)列号,$NF代表最后一列 |
数据集:
[root@hab1 /root]# cat /server/files/awkfile.txt
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
sync:x:5:0:sync:/sbin:/bin/sync
shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
halt:x:7:0:halt:/sbin:/sbin/halt
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
operator:x:11:0:operator:/root:/sbin/nologin
[root@hab1 /root]#
思考:
一共有多少行呢?你如何知道的?通过什么标志?
awk对每个要处理的输入数据认为都是具有格式和结构的,而不仅仅是一堆字符串。默认情况下,==每一行内容都是一条记录==,并以==换行符==分隔(\n)结束。

awk默认情况下每一行都是一个记录(record)
① RS既record separator输入输出数据记录分隔符,每一行是怎么没的,表示每个记录输入的时候的分隔符,既行与行之间如何分隔,默认为\n,可以调整为其他字符。
② NR既number of record 记录(行)号,表示当前正在处理的记录(行)的号码。
③ ORS既output record separator 输出记录分隔符。
awk使用内置变量RS来存放输入记录分隔符,RS表示的是输入的记录分隔符,这个值可以通过==BEGIN模块==重新定义修改。
案例1:
[root@hab1 /root]# cat /server/files/awkfile.txt
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
sync:x:5:0:sync:/sbin:/bin/sync
shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
halt:x:7:0:halt:/sbin:/sbin/halt
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
operator:x:11:0:operator:/root:/sbin/nologin

[root@hab1 /root]# awk 'BEGIN{RS="/"}{print NR,$0}' /server/files/awkfile.txt
1 root:x:0:0:root:
2 root:
3 bin
4 bash
bin:x:1:1:bin:
5 bin:
6 sbin
7 nologin
daemon:x:2:2:daemon:
8 sbin:
9 sbin
10 nologin
adm:x:3:4:adm:
11 var
12 adm:
13 sbin
14 nologin
lp:x:4:7:lp:
15 var
16 spool
17 lpd:
18 sbin
19 nologin
sync:x:5:0:sync:
20 sbin:
21 bin
22 sync
shutdown:x:6:0:shutdown:
23 sbin:
24 sbin
25 shutdown
halt:x:7:0:halt:
26 sbin:
27 sbin
28 halt
mail:x:8:12:mail:
29 var
30 spool
31 mail:
32 sbin
33 nologin
operator:x:11:0:operator:
34 root:
35 sbin
36 nologin

[root@hab1 /root]# awk 'BEGIN{RS="/"}{gsub(/\n/,"");print NR,$0}' /server/files/awkfile.txt
1 root:x:0:0:root:
2 root:
3 bin
4 bashbin:x:1:1:bin:
5 bin:
6 sbin
7 nologindaemon:x:2:2:daemon:
8 sbin:
9 sbin
10 nologinadm:x:3:4:adm:
11 var
12 adm:
13 sbin
14 nologinlp:x:4:7:lp:
15 var
16 spool
17 lpd:
18 sbin
19 nologinsync:x:5:0:sync:
20 sbin:
21 bin
22 syncshutdown:x:6:0:shutdown:
23 sbin:
24 sbin
25 shutdownhalt:x:7:0:halt:
26 sbin:
27 sbin
28 haltmail:x:8:12:mail:
29 var
30 spool
31 mail:
32 sbin
33 nologinoperator:x:11:0:operator:
34 root:
35 sbin
36 nologin
以上两条命令解释
第一条命令解释
awk 'BEGIN{RS="/"}{print NR,$0}' /server/files/awkfile.txt
命令说明:
BEGIN模块在awk开始处理文件数据之前执行1次,RS="/"表示把记录分隔符设置为 /,awk不再按默认换行符切割记录,而是遇到 / 就切割成一段记录。
NR代表awk自动累加的记录编号,$0代表当前切割出来的一整段完整记录内容。
awk从头到尾把文件当成一整串连续字符处理,\n换行符也只是普通字符,每切割出一段记录,就执行print NR,$0打印记录编号 + 本段完整内容,原始内容里的换行符会被保留,直接输出换行。
第二条命令解释
awk 'BEGIN{RS="/"}{gsub(/\n/,""); print NR,$0}' /server/files/awkfile.txt
命令说明:
BEGIN模块在awk开始处理文件数据之前执行1次,RS="/"表示把记录分隔符设置为 /,awk遇到 / 就切割成一段记录。
gsub(/\n/,"")是全局替换动作,把当前整段记录$0里所有的换行符 \n 替换为空(删除换行符)。
NR代表记录编号,$0代表删除换行后的当前段完整内容。
awk每切割出一段记录,先删除本段内所有换行,再执行print NR,$0打印记录编号 + 清理后的内容,不会保留原始换行,内容会紧凑拼接输出。
极简对照
- 第一条:按 / 分段 → 原样输出(保留换行)
- 第二条:按 / 分段 → 先删换行 → 再输出
我们回顾下“行(记录)”到底是什么意思?
行(记录):默认以\n(回车换行)结束,而这个行的结束就是记录分隔符。
所以在awk中,RS(记录分隔符)变量表示着行的结束符号(默认是回车换行)
在工作中,我们可以通过修改RS变量的值来决定行的结束标志,最终来决定“每行”的内容。
为了方便人们理解,awk默认就把RS的值设置为“\n”
注意:
awk的BEGIN模块,我会在后面(模式-BEGIN模块)详细讲解,此处大家仅需要知道在BEGIN模块里面我们来定义一些awk内置变量即可。
对$0的认识
awk '{print NR,NF,0,1,2,...}'
NR:行号,打印行号
NF:NF代表列号,如果前面添加了,则代表最后一列
$0:整行内容
1:按照-F分割后,1代表分割后的第1列
2:按照-F分割后,2代表分割后的第2列
由以上代码运行可知:awk中0表示整行,其实awk使用0来表示整条记录。记录分隔符存在RS变量中或者说每个记录以RS内置变量结束。
另外,awk对每一行的记录号都有一个内置变量NR来保存,每处理完一条记录,NR的值就会自动+1
案例2:NR记录行号
[root@hab1 /root]# awk '{print NR,$0}' /server/files/awkfile.txt
1 root:x:0:0:root:/root:/bin/bash
2 bin:x:1:1:bin:/bin:/sbin/nologin
3 daemon:x:2:2:daemon:/sbin:/sbin/nologin
4 adm:x:3:4:adm:/var/adm:/sbin/nologin
5 lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
6 sync:x:5:0:sync:/sbin:/bin/sync
7 shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
8 halt:x:7:0:halt:/sbin:/sbin/halt
9 mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
10 operator:x:11:0:operator:/root:/sbin/nologin

命令说明:
NR既number of record,当前记录的记录号,刚开始学也可以理解为行号。
$0表示整行或者说整个记录
企业面试题:按单词出现频率降序排序(计算文件中每个单词的重复数量)
[root@hab1 /root]# sed -r '1,10 s#[^a-zA-Z]+# #g' /etc/passwd | head >/server/files/count.txt
[root@hab1 /root]# cat /server/files/count.txt
root x root root bin bash
bin x bin bin sbin nologin
daemon x daemon sbin sbin nologin
adm x adm var adm sbin nologin
lp x lp var spool lpd sbin nologin
sync x sync sbin bin sync
shutdown x shutdown sbin sbin shutdown
halt x halt sbin sbin halt
mail x mail var spool mail sbin nologin
operator x operator root sbin nologin

1,10:限定处理1 到 10 行
[^a-zA-Z]+:匹配所有非字母
s###g:全局替换为空格
| head:取前 10 行
>:输出到文件
思路:
让所有单词排成一列,这样每个单词都是单独的一行
① 设置RS值为空格
② 将文件里面的所有空格替换为回车换行符“\n”
③ 基于sort + uniq -c实现词频统计
方法一:
awk 'BEGIN{RS="[ ]+"}{print $0}' /server/files/count.txt | sort | uniq -c | sort -nr
方法二:
cat /server/files/count.txt | tr " " "\n" | sort | uniq -c | sort -nr
实战分析:
[root@hab1 /root]# awk 'BEGIN{RS="[ ]+"}{print $0}' /server/files/count.txt | sort | uniq -c | so
     12 sbin
     10 x
      6 nologin
      5 bin
      4 root
      3 var
      3 sync
      3 shutdown
      3 mail
      3 halt
      3 adm
      2 spool
      2 operator
      2 lp
      2 daemon
      1 lpd
      1 bash
      1
[root@hab1 /root]# cat /server/files/count.txt | tr " " "\n" | sort | uniq -c | sort -nr
     12 sbin
     10 x
      6 nologin
      5 bin
      4 root
      3 var
      3 sync
      3 shutdown
      3 mail
      3 halt
      3 adm
      2 spool
      2 operator
      2 lp
      2 daemon
      1 lpd
      1 bash
两条命令核心区别:实现方式不同,但结果几乎一样,唯一差别是 awk 多统计了一个空行(数字1那行)
先看两条命令的目标
两条命令完全相同的目标:
- 把
/server/files/count.txt里所有单词按空格拆分成每行一个 - 排序
- 统计每个单词出现次数
- 按次数从大到小排序
第一条命令(awk 版)
awk 'BEGIN{RS="[ ]+"}{print $0}' /server/files/count.txt | sort | uniq -c | sort -nr
拆解说明:
-
BEGIN{RS="[ ]+"} -
- RS = 记录分隔符
[ ]+表示 一个或多个空格- 意思:遇到空格就分段,每一段作为一行输出
-
{print $0}打印每一段 -
后面管道:排序 → 统计 → 倒序
缺点:
awk 按空格切割时,容易切出空行,所以结果里会多一行:(这是一个空字符串统计)
第二条命令(tr 版,更干净)
cat /server/files/count.txt | tr " " "\n" | sort | uniq -c | sort -nr
拆解说明:
-
tr " " "\n" -
- tr = 字符替换
- 把所有空格 替换成 换行符
- 最直接、最简单、最干净
-
每行变成一个单词
-
后面流程相同
优点:
不会产生空行,结果更干净。
核心区别总结
| 命令 | 实现方式 | 优点 | 缺点 |
|---|---|---|---|
| awk | 按一个或多个空格分段 | 灵活 | 会产生空行 |
| tr | 把空格直接换成换行 | 简单、干净、无空行 | 不够灵活,但这里够用 |
一句话总结
- awk 那条:用空格分段拆分单词,会多统计一个空行。
- tr 那条:用空格转换行拆分单词,最干净、没有空行。
- 业务统计结果完全一致。
小结:
以后遇到词频统计,大致处理流程都是一样的:① 想办法把每个单词单独放一行 ② sort + uniq -c ③ 最后在升序或降序
6. awk 记录知识小结
基本语法:
awk  -F "分隔符"  '模式 + 动作'  要处理的文件

分隔符,需不需要根据某个符号提取某1列
模式,匹配指定行信息 => NR,&&逻辑与,BEGIN{RS="行与行之间分隔符"}
动作,拿到模式匹配的结果要做什么 => {print $0$1$2}
NR存放着每个记录的号(行号)读取新行时候会自动+1
RS是输入数据的记录的分隔符,简单理解就是可以指定每个记录的结尾标志。
RS作用就是表示一个记录的结束
当我们修改了RS的值,最好配合NR(行)来查看变化,也就是修改了RS的值通过NR查看结果,调试awk程序。
ORS输出数据的记录的分隔符
awk学习技巧一则:
大象放冰箱分几步?打开冰箱,把大象放进去,关闭冰箱门。
awk也是一样的,一步一步来,先修改了RS,然后用NR调试,看看到底如何分隔的。然后通过sort排序,uniq -c去重
7. awk 字段(列)
每条记录都是由多个区域(field)组成的,默认情况下区域之间的分隔符是由空格(即空格或制表符)来分隔,并且将分隔符记录在内置变量FS中,每行记录的区域数保存在awk的内置变量NF中。

FS既field separator,输入字段(列)分隔符。分隔符就是菜刀,把一行字符串切为很多个区域。
NF既number of fileds,表示一行中列(字段)的个数,可以理解为菜刀切过一行后,切成了多少份。
OFS输出字段(列)分隔符
① awk使用内置变量FS来记录区域分隔符的内容,FS可以在命令行上通过-F参数来更改,也可以通过BEGIN模块来更改。
② 然后通过n(n是整数),来取被切割后的区域,1取第一个区域,2取第二个区域,NF取最后一个区域。
案例1:指定分隔符
[root@hab1 /root]# cat /server/files/awkfile.txt
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
lp:x:4:7:lp:/var/spool/lpd:/sbin/nologin
sync:x:5:0:sync:/sbin:/bin/sync
shutdown:x:6:0:shutdown:/sbin:/sbin/shutdown
halt:x:7:0:halt:/sbin:/sbin/halt
mail:x:8:12:mail:/var/spool/mail:/sbin/nologin
operator:x:11:0:operator:/root:/sbin/nologin
[root@hab1 /root]# awk -F ":" 'NR>=2&&NR<=5{print $1,$3}' /server/files/awkfile.txt
bin 1
daemon 2
adm 3
lp 4

命令说明:
以:(冒号)为分隔符,显示第2行到第5行之间的第一区域和第三区域。
案例2:提取字符串中的多处内容
[root@hab1 /root]# echo "I am eric,my qq is 1234567890" >> /server/files/test.txt
[root@hab1 /root]# cat /server/files/test.txt
I am eric,my qq is 1234567890
思路:
我们用默认的想法一次使用一把刀,需要配合管道的。如何同时使用两把刀呢?
[root@hab1 /root]# cat /server/files/test.txt
I am eric,my qq is 1234567890
[root@hab1 /root]# awk -F "[ ,]" '{print $3,$NF}' /server/files/test.txt
eric 1234567890
[root@hab1 /root]# awk -F "[ ,]" '{print $5,$NF}' /server/files/test.txt
qq 1234567890
[root@hab1 /root]# awk -F "[ ,]" '{print $3,$5,$NF}' /server/files/test.txt
eric qq 1234567890
[root@hab1 /root]#

命令说明:
通过命令-F参数指定区域分隔符
[ ,]是正则表达式里面的内容,它表示一个整体,“一个”字符,既空格或者逗号(,),合并在一起,-F “[ ,]”就表示以空格或者逗号(,)为区域分隔符
小技巧:
在动作(‘{print 3,NF}’)里面的逗号,表示空格,其实动作中的逗号就是OFS的值。刚开始大家把动作中的逗号,当作空格即可。
8. awk 分隔符
[root@hab1 /root]# vim /server/files/awkfile.txt
[root@hab1 /root]# cat /server/files/awkfile.txt
          inet addr:192.168.88.101  Bcast:192.168.88.255
Mask:255.255.255.0
[root@hab1 /root]# awk '{print $1}' /server/files/awkfile.txt
inet
[root@hab1 /root]# awk -F "[ :]" '{print $1}' /server/files/awkfile.txt
[root@hab1 /root]# awk -F "[ :]+" '{print $2}' /server/files/awkfile.txt
inet
[root@hab1 /root]# awk -F "[ :]+" '{print $3}' /server/files/awkfile.txt
addr
[root@hab1 /root]# awk -F "[ :]+" '{print $4}' /server/files/awkfile.txt
192.168.88.101
[root@hab1 /root]# awk -F "[ :]+" '{print $5}' /server/files/awkfile.txt
Bcast
[root@hab1 /root]# awk -F "[ :]+" '{print $6}' /server/files/awkfile.txt
192.168.88.255

命令说明:
awk默认的FS分隔符对于空格序列,一个空格或多个空格tab都认为是一样的,一个整体。
[ :] = 匹配 空格 或 冒号
+ = 一个或多个
合起来:"[ :]+" 连续的空格 / 冒号 = 一个分隔符
因为开头是空格,所以 $1 为空,$2 才是 inet
正常情况下,切割后,数据都是从$1开始
但是如果一个文件的开头有很多连续的空格,然后才是inet这个字符
当我们使用默认的分隔符的时候,$1是有内容
当我们指定其他分隔符(非空格)时候,区域会有所变化,$2才有内容
9. 字段与记录小结
现在你应该会对awk的记录字段有所了解了,下面我们总结一下,学会给阶段性知识总结是学好运维的必备技能。

RS记录分隔符,表示每行的结束标志
NR行号(记录号)
FS字段分隔符,每列的分隔标志或结束标志
NF就是每行有多少列,每个记录中字段的数量
符号表示取某个列(字段),12NF
NF表示记录中的区域(列)数量,$NF取最后一个列(区域。)
FS(-F)字段(列)分隔符,-F(FS)":" <==> 'BEGIN{FS=":"}'
RS 记录分隔符(行的结束标识)
NR 行号
选好合适的刀FS,RS,OFS,ORS
分隔符==>结束标识
记录与区域,你就对我们所谓的行与列,有了新的认识(RS,FS)
10. awk 模式与动作进阶
awk模式与动作
接下来就详细介绍下,awk的模式都有几种:
☆ 正则表达式作为模式
☆ 比较表达式作为模式
☆ 范围模式
☆ 特殊模式BEGIN和END
案例1:awk正则表达式匹配整行
awk '/正则表达式/'
awk '$0~/正则表达式/'
[root@hab1 /data]# cat awkfile.txt
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
mysql:x:999:999:MySQL Server:/home/mysql:/bin/bash
nginx:x:1000:1000:NGINX User:/home/nginx:/sbin/nologin
[root@hab1 /data]# awk -F ":" '/^root/' awkfile.txt
root:x:0:0:root:/root:/bin/bash
[root@hab1 /data]# awk -F ":" '$0~/^root/' awkfile.txt
root:x:0:0:root:/root:/bin/bash

awk -F ":" '/^root/' awkfile.txt

/^root/
正则表达式:匹配以 root 开头的行
^ = 行首
^root = 这一行开头是 root

awk -F ":" '$0~/^root/' awkfile.txt

$0~/^root/
$0 = 整行内容
~ = 匹配正则
/$0~/^root/ = 整行 匹配 以 root 开头
案例2:awk正则表达式匹配一行中的某一列
[root@hab1 /data]# cat awkfile.txt
root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
mysql:x:999:999:MySQL Server:/home/mysql:/bin/bash
nginx:x:1000:1000:NGINX User:/home/nginx:/sbin/nologin

[root@hab1 /data]# awk -F ":" '$5~/daemon/' awkfile.txt
daemon:x:2:2:daemon:/sbin:/sbin/nologin

awk -F ":" '$5~/daemon/' awkfile.txt

1. awk
启动 awk 工具

2. -F ":"
字段分隔符 = 冒号 :意思:把每一行按 : 切成一段一段,每一段叫一个字段

比如这一行:
daemon:x:2:2:daemon:/sbin:/sbin/nologin

会被切成:
$1  $2 $3 $4  $5     $6    $7
daemon:x:2:2:daemon:/sbin:/sbin/nologin

3. $5
第 5 个字段就是按 : 分割后的第 5 段内容

4. ~
匹配正则表达式不是等于,是包含 / 匹配

5. /daemon/
正则:包含字符串 daemon

6. $5~/daemon/
整句意思:第 5 个字段 包含 daemon 这个字符串

7. awkfile.txt
要处理的文件

[root@hab1 /data]# awk -F ":" '$1~/daemon/' awkfile.txt
daemon:x:2:2:daemon:/sbin:/sbin/nologin
[root@hab1 /data]# awk -F ":" '$1~/bin/' awkfile.txt
bin:x:1:1:bin:/bin:/sbin/nologin
案例3:某个区域中的开头和结尾
知道了如何使用正则表达式匹配操作符之后,我们来看看awk正则与grep和sed不同的地方。
awk正则表达式:
| ^ | 匹配一个字符串的开头 |
|---|---|
| $ | 匹配一个字符串的结尾 |
数据集
cat >reg.txt<<EOF
Zhang Dandan    41117397    :250:100:175
Zhao  Xiaoyu    390320151   :155:90:201
Meng  Feixue    80042789    :250:60:50
Wu    Yujia     70271111    :250:80:75
Liu   Bingbing  41117483    :250:100:175
Wang  Yangming  3515064655  :50:95:135
Guan  Tingting  1986787350  :250:168:200
Li    Xinxin     918391635   :175:75:300
Liao  Feifan     918391635   :250:100:175
EOF
说明:
第一列是姓氏
第二列是名字
第一列第二列合起来就是姓名
第三列是对应的ID号码
最后三列是三次捐款数量
练习题1:显示姓Zhang的人的第二次捐款金额及她的名字
[root@hab1 /data]# cat reg.txt
Zhang Dandan    41117397    :250:100:175
Zhao  Xiaoyu    390320151   :155:90:201
Meng  Feixue    80042789    :250:60:50
Wu    Yujia     70271111    :250:80:75
Liu   Bingbing  41117483    :250:100:175
Wang  Yangming  3515064655  :50:95:135
Guan  Tingting  1986787350  :250:168:200
Li    Xinxin     918391635   :175:75:300
Liao  Feifan     918391635   :250:100:175

[root@hab1 /data]# awk -F "[ :]+" '$1~/^Zhang/{print $2,$(NF-1)}' reg.txt
Dandan 100

awk -F "[ :]+" '$1~/^Zhang/{print $2,$(NF-1)}' reg.txt

-F"[ :]+"  :以一个/多个空格或冒号为分隔符
$1~/^Zhang/:第1列以Zhang开头
print $2,$(NF-1):打印第2列、倒数第2列
练习题2:显示Xiaoyu的名字和ID号码,并以逗号隔开
[root@hab1 /data]# cat reg.txt
Zhang Dandan    41117397    :250:100:175
Zhao  Xiaoyu    390320151   :155:90:201
Meng  Feixue    80042789    :250:60:50
Wu    Yujia     70271111    :250:80:75
Liu   Bingbing  41117483    :250:100:175
Wang  Yangming  3515064655  :50:95:135
Guan  Tingting  1986787350  :250:168:200
Li    Xinxin     918391635   :175:75:300
Liao  Feifan     918391635   :250:100:175
[root@hab1 /data]# awk -F "[ :]+" '$2~/^Xiaoyu$/{print $1","$3}' reg.txt
Zhao,390320151

awk -F "[ :]+" '$2~/^Xiaoyu$/{print $1","$3}' reg.txt

-F "[ :]+" 空格/冒号多分隔符
$2~/^Xiaoyu$/ 第2列精确等于Xiaoyu
print $1,$3 打印第1、3列,逗号分隔
练习题3:显示所有以41开头的ID号码的人的全名和ID号码
[root@hab1 /data]# cat reg.txt
Zhang Dandan    41117397    :250:100:175
Zhao  Xiaoyu    390320151   :155:90:201
Meng  Feixue    80042789    :250:60:50
Wu    Yujia     70271111    :250:80:75
Liu   Bingbing  41117483    :250:100:175
Wang  Yangming  3515064655  :50:95:135
Guan  Tingting  1986787350  :250:168:200
Li    Xinxin     918391635   :175:75:300
Liao  Feifan     918391635   :250:100:175
[root@hab1 /data]# awk -F "[ :]+" '$3~/^(41)/{print $1,$2,$3}' reg.txt
Zhang Dandan 41117397
Liu Bingbing 41117483

awk -F "[ :]+" '$3~/^(41)/{print $1,$2,$3}' reg.txt

-F "[ :]+"   以空格/冒号为分隔符
$3~/^(41)/   第3列以41开头
print $1,$2,$3 打印1、2、3列
练习题4:显示所有以一个D或X开头的人名全名
[root@hab1 /data]# cat reg.txt
Zhang Dandan    41117397    :250:100:175
Zhao  Xiaoyu    390320151   :155:90:201
Meng  Feixue    80042789    :250:60:50
Wu    Yujia     70271111    :250:80:75
Liu   Bingbing  41117483    :250:100:175
Wang  Yangming  3515064655  :50:95:135
Guan  Tingting  1986787350  :250:168:200
Li    Xinxin     918391635   :175:75:300
Liao  Feifan     918391635   :250:100:175
[root@hab1 /data]# awk -F "[ :]+" '$2~/^D|^X/{print $1,$2}' reg.txt
Zhang Dandan
Zhao Xiaoyu
Li Xinxin

awk -F "[ :]+" '$2~/^D|^X/{print $1,$2}' reg.txt

awk                # 调用awk文本处理工具
-F "[ :]+"         # 分隔符:1个/多个空格或冒号
'
$2                 # 匹配第2个字段
~                  # 正则匹配
/^D|^X/            # 以D开头 或者 以X开头
{
print $1,$2        # 打印第1列、第2列
}
'
reg.txt            # 操作文件
练习题5:显示所有ID号码最后一位数字是1或5的人的全名
[root@hab1 /data]# cat reg.txt
Zhang Dandan    41117397    :250:100:175
Zhao  Xiaoyu    390320151   :155:90:201
Meng  Feixue    80042789    :250:60:50
Wu    Yujia     70271111    :250:80:75
Liu   Bingbing  41117483    :250:100:175
Wang  Yangming  3515064655  :50:95:135
Guan  Tingting  1986787350  :250:168:200
Li    Xinxin     918391635   :175:75:300
Liao  Feifan     918391635   :250:100:175
[root@hab1 /data]# awk -F "[ :]+" '$3~/1$|5$/{print $1,$2}' reg.txt
Zhao Xiaoyu
Wu Yujia
Wang Yangming
Li Xinxin
Liao Feifan

awk -F "[ :]+" '$3~/1$|5$/{print $1,$2}' reg.txt

awk                # 调用awk文本处理工具
-F "[ :]+"         # 分隔符:1个/多个空格或冒号
'
$3                 # 匹配第3个字段
~                  # 正则匹配
/1$|5$/            # 以1结尾  或者  以5结尾
{
print $1,$2        # 打印第1列、第2列
}
'
reg.txt            # 操作文件
特别说明:
print $1,$2,$3     # 逗号 = 自动空格分隔 → A B C
print $1"-"$2"-"$3 # 无逗号,手写符号 → A-B-C
print $1","$2","$3 # 无逗号,手写逗号 → A,B,C
案例4:取出网卡ens160的IP地址
CentOS6 => eth0
CentOS7 => ens33
CentOS Stream 9 => ens160
最简单:hostname -I
[root@hab1 /root]# hostname -I
192.168.80.11

[root@hab1 /root]# ifconfig ens160 | sed -n '2p'
        inet 192.168.80.11  netmask 255.255.255.0  broadcast 192.168.80.255
[root@hab1 /root]# ifconfig ens160 | sed -n '2p' | awk -F "[ ]+" '{print $3}'
192.168.80.11
[root@hab1 /root]# ifconfig ens160 | sed -n '2p' | awk '{print $3}'
netmask
[root@hab1 /root]# ifconfig ens160 | sed -n '2p' | awk '{print $2}'
192.168.80.11

ifconfig ens160      # 查看 ens160 网卡信息
sed -n '2p'          # 取第 2 行(inet 所在行)
awk -F"[ ]+"         # 以**1个或多个空格**为分隔符
'{print $3}'         # 打印第 3 个字段(IP地址)

[root@hab1 /root]# ifconfig ens160 | sed -n '2p' | awk -F "[ ]+" '{split($3,ip,"/"); print ip[1]}'
192.168.80.11

ip a                  # 查看网卡信息
grep ens160           # 过滤网卡ens160行
sed -n '2p'           # 取第二行(inet 那行)
awk -F"[ ]+"          # 以空格为分隔符
split($3,ip,"/")      # 把 $3 按 / 切割成数组 ip
print ip[1]           # 输出数组第一个元素(纯IP)
案例5:取出常用服务端口号
思路:Linux下面服务与端口信息的对应表格在/etc/services里面,所以这道题要处理/etc/services文件
[root@hab1 /root]# sed -n '23,30p' /etc/services
tcpmux          1/tcp                           # TCP port service multiplexer
tcpmux          1/udp                           # TCP port service multiplexer
rje             5/tcp                           # Remote Job Entry
rje             5/udp                           # Remote Job Entry
echo            7/tcp
echo            7/udp
discard         9/tcp           sink null
discard         9/udp           sink null
从23行开始基本上每一行第一列是服务名称,第二列的第一部分是端口号,第二列的第二部分是tcp或udp协议。
[root@hab1 /root]# awk -F "[ /]+" '$1~/^ssh$|^http$|^httpd$|^mysql$|^nginx$|^ftp$/{print $1,$2}' /etc/services | sort | uniq
ftp 21
http 80
mysql 3306
ssh 22

命令解释:

1. awk
调用 awk 文本处理工具。

2. -F "[ /]+"
-F:设置字段分隔符
[ /]:表示空格 或 斜杠 / 中的任意一种
+:表示连续一个或多个都算一个分隔符
作用:把空格和 / 都当作分段符。

3. $1
代表第 1 个字段(服务名称,如 ssh、http)

4. ~
正则匹配运算符表示:左边的字段 匹配 右边的正则表达式

5. /^(ssh)$|^(http)$|^(https)$|^(mysql)$|^(ftp)$/
这是正则表达式核心,逐符号解释:
^:匹配行开头 / 字符串开头
$:匹配字符串结尾
(ssh):精确匹配字符串 ssh
|:逻辑或
整段意思:精确匹配:ssh 或 http 或 https 或 mysql 或 ftp(^...$ 保证是完全相等,不是包含)

6. {print $1,$2}
匹配成功后执行
$1:服务名
$2:端口号
逗号,:输出默认用空格分隔

7. /etc/services
Linux 系统文件,存放:服务名 ↔ 端口号 对应关系

8. | sort
将结果按字母顺序排序

9. | uniq
去除重复行(因为同一个服务可能有 tcp/udp 两条)
11. BEGIN 模式与 END 模式

☆ BEGIN模式
BEGIN模块再awk读取文件之前就执行,一般用来定义我们的内置变量(预定义变量,eg:FS,RS),可以输出表头(类似excel表格名称)
BEGIN模式之前我们有在示例中提到,自定义变量,给内容变量赋值等,都使用过。需要注意的是BEGIN模式后面要接跟一个action操作块,包含在大括号内。awk必须在输入文件进行任何处理前先执行BEGIN里的动作(action)。我们可以不要任何输入文件,就可以对BEGIN模块进行测试,因为awk需要先执行完BEGIN模式,才对输入文件做处理。BEGIN模式常常被用来修改内置变量ORS,RS,FS,OFS等值。
案例1:可以使用BEGIN设定表头信息
[root@hab1 /root]# cat >awkfile.txt<<EOF
> root:x:0:0:root:/root:/bin/bash
bin:x:1:1:bin:/bin:/sbin/nologin
daemon:x:2:2:daemon:/sbin:/sbin/nologin
adm:x:3:4:adm:/var/adm:/sbin/nologin
mysql:x:999:999:MySQL Server:/home/mysql:/bin/bash
nginx:x:1000:1000:NGINX User:/home/nginx:/sbin/nologin
> EOF
[root@hab1 /root]# awk -F: '{print $1,$3}' awkfile.txt
root 0
bin 1
daemon 2
adm 3
mysql 999
nginx 1000
[root@hab1 /root]# awk -F: 'BEGIN{print "username","UID"}{print $1,$3}' awkfile.txt
username UID
root 0
bin 1
daemon 2
adm 3
mysql 999
nginx 1000
说明:
要在第一行输出一些username和UID,我们应该想到BEGIN{}这个特殊的条件(模式),因为BEGIN{}在awk读取文件之前执行的。
所以结果是BEGIN{print "username","UID"},注意print命令里面双引号吃啥吐啥,原样输出。
然后我们实现了在输出文件内容之前输出“username”和“UID”,下一步输出文件的第一列和第三列即{print 1,3}
最后结果就是BEGIN{print "username","UID"}{print 1,3}
案例2:awk变量
直接定义,直接使用即可
awk命令不仅可以进行数据获取分析,还支持数学运算!
awk中字母会被认为是变量,如果真的要给一个变量赋值字母(字符串),请使用= 和 "" 双引号
# 数字变量
awk 'BEGIN{a=123; print a}'        # 输出 123
[root@hab1 /root]# awk 'BEGIN{a=123; print a}'
123

# 字符串变量(必须双引号)
awk 'BEGIN{a="abcd"; print a}'     # 输出 abcd
[root@hab1 /root]# awk 'BEGIN{a="abcd"; print a}'
abcd

# 变量赋值变量
awk 'BEGIN{b=456; a=b; print a}'   # 输出 456
[root@hab1 /root]# awk 'BEGIN{b=456;a=b; print a}'
456

# 错误写法(abcd 被当作变量,无值)
awk 'BEGIN{a=abcd; print a}'      # 输出空
[root@hab1 /root]# awk 'BEGIN{a=abcd; print a}'

[root@hab1 /root]#
☆ END模式
作用:与BEGIN相呼应,在awk处理文件结束后,会自动触发END模块(只会触发1次)
案例1:统计/etc/servies文件里的空行数量
思路:
a) 空行通过正则表达式来实现:^$
b) 统计数量
grep方法:
[root@hab1 /root]# grep "^$" /etc/services | wc -l
16
[root@hab1 /root]# grep -c "^$" /etc/services
16
awk方法:
[root@hab1 /root]# awk '/^$/{i=i+1} END{print "blank lines count:"i}' /etc/services
blank lines count:16

awk                    执行awk命令
/^$/                    匹配空行(开头和结尾之间没有内容)
{i=i+1}                 每匹配到一行空行,变量 i 就 +1
END                     所有行处理完毕后执行
{print "blank lines count"}   输出提示文字 + 最终统计的空行数
/etc/services           要处理的文件
案例2:awk支持数学运算
[root@hab1 /root]# echo | awk '{print 1+2}'
3
[root@hab1 /root]# echo | awk '{print 2*2}'
4
[root@hab1 /root]# echo | awk '{print 2+2.5}'
4.5
案例3:文件count.txt,文件内容是1到100(由seq 100生成),请计算文件每行值加起来的结果(计算1+...+100)
思路:
文件每一行都有且只有一个数字,所以我们要让文件的每行内容相加。
回顾一下上一道题我们用的是i++即i=i+1
这里我们需要使用到第二个常用的表达式
i=i+$0
对比一下,其实只是把上边的1换成了$0
创建测试文件
# 生成 1-100 数字,每行一个
seq 100 > count.txt
[root@hab1 /root]# seq 100 > count.txt
[root@hab1 /root]# awk '{i=i+$0} END{print i}' count.txt
5050

awk             # 调用awk文本处理工具
{               # 对每一行都执行
i=i+$0          # 核心公式:
                # i = 累加总和(初始默认为0)
                # $0 = 当前行的数字(1、2、3...100)
                # 每读一行,就把当前行数字加到总和里
}
END             # 所有行读取完毕后执行
{print i}       # 输出最终累加结果
count.txt       # 要计算的文件
注意:
在 awk 里,只要是数字运算,没赋值过的变量,默认就是 0!
i 从来没有被赋值过
awk 遇到未赋值的变量 + 数字运算
自动把 i 当成 0
[root@hab1 /root]# awk 'BEGIN{print i}'

[root@hab1 /root]# awk 'BEGIN{print i+1}'
1
[root@hab1 /root]# awk 'BEGIN{print i+2}'
2
12. awk 数组
awk提供了"数组"来存放一组相关的值。
awk是一种编程语言,肯定也支持数组的运用,但是又不同于C语言的数组。数组在awk中被称为关联数组,因为它的下标既可以是数字也可以是字符串。下标通常被称作key,并且与对应的数组元素的值关联。数组元素的key和值都存储在awk程序内部的一张表中,通过一定散列算法来存储,所以数组元素都不是按顺序存储的。打印出来的顺序也肯定不是按照一定的顺序,但是我们可以通过管道来对所需的数据再次操作来达到自己的效果。
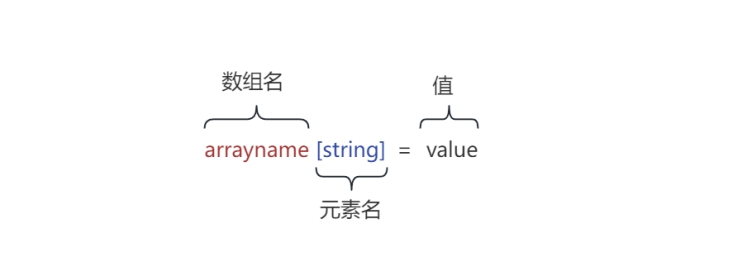
students[a]="张三"
students[b]="李四"
students[c]="王五"
数组[索引值]="元素值",要求:索引值在数组中是不重复的
大白话讲数组:awk数组就和酒店一样,数组的名称就像是酒店名称,数组元素名称就像酒店房间号码,每个数组元素里面的内容就像是酒店房间里面的人。
假设我们有一个酒店:
酒店里面有几个房间110,119,120,114这几个房间
酒店<===>hotel
酒店110房间<===>hotel[110]
酒店120房间<===>hotel[120]
酒店119房间<===>hotel[119]
酒店114房间<===>hotel[114]
酒店房间入驻客人
酒店110房间住着xiaoyu<===>hotel[110]="xiaoyu"
酒店119房间住着ruxue<===>hotel[119]="ruxue"
酒店120房间住着dandan<===>hotel[120]="dandan"
酒店114房间住着bingbing<===>hotel[114]="bingbing"
案例1:
[root@hab1 /root]# awk 'BEGIN{hotel[110]="xiaoyu";hotel[119]="ruxue";hotel[120]="dandan";hotel[114]="bingbing";print hotel[110],hotel[119],hotel[120],hotel[114]}'
xiaoyu ruxue dandan bingbing
案例2:
[root@hab1 /root]# awk 'BEGIN{hotel[110]="xiaoyu";hotel[119]="ruxue";hotel[120]="dandan";hotel[114]="bingbing";for(i in hotel) print i,hotel[i]}'
110 xiaoyu
114 bingbing
119 ruxue
120 dandan
案例3:统计域名访问次数
post.ithuang.com 2
mp3.ithuang.com 1
cat >web_file.txt<<EOF
http://www.ithuang.com/index.html
http://www.ithuang.com/1.html
http://post.ithuang.com/index.html
http://mp3.ithuang.com/index.html
http://www.ithuang.com/3.html
http://post.ithuang.com/2.html
EOF
思路:
1)以斜线为刀取出第二列(域名)
2)创建一个数组
3)把第二列(域名)作为数组的下标
4)通过类似于i++的形式进行计数
5)统计后把结果输出
第一步:查看一下内容
[root@hab1 /data]# cat web_file.txt
http://www.ithuang.com/index.html
http://www.ithuang.com/1.html
http://post.ithuang.com/index.html
http://mp3.ithuang.com/index.html
http://www.ithuang.com/3.html
http://post.ithuang.com/2.html
[root@hab1 /data]# awk -F "[/]+" '{print $2}' web_file.txt
www.ithuang.com
www.ithuang.com
post.ithuang.com
mp3.ithuang.com
www.ithuang.com
post.ithuang.com

awk             执行awk文本处理
-F "[/]+"       分隔符:以 斜杠 / 作为分隔符
                + 表示连续多个 / 只算一个
{print $2}      打印 第2个字段
web_file.txt    处理的文件
第二步:计数
[root@hab1 /data]# awk -F "[/]+" '{i++;print $2,i}' web_file.txt
www.ithuang.com 1
www.ithuang.com 2
post.ithuang.com 3
mp3.ithuang.com 4
www.ithuang.com 5
post.ithuang.com 6

awk             调用awk处理工具
-F "[/]+"       分隔符:以 / 分割每行
{i++;           每处理一行,变量 i 自动 +1(行号计数)
print $2,i}     打印:第2段内容(域名) + 当前行号
web_file.txt    要处理的文件
第三步:用数组替换i
awk 的数组下标可以是字符串、数字,甚至是字符串拼接的结果。
准确写法(掌握)
[root@hab1 /data]# awk -F "[/]+" '{h[$2]++;print $2,h[$2]}' web_file.txt
www.ithuang.com 1
www.ithuang.com 2
post.ithuang.com 1
mp3.ithuang.com 1
www.ithuang.com 3
post.ithuang.com 2

-F "[/]+"        以 / 作为分隔符
h[$2]++          【核心】数组 h,以域名为下标,计数+1
print $2         打印当前域名
第四步:输出最终计数结果
[root@hab1 /data]# awk -F "[/]+" '{h[$2]++} END{for(i in h)print i,h[i]}' web_file.txt | sort -k2 -nr
www.ithuang.com 3
post.ithuang.com 2
mp3.ithuang.com 1

-F "[/]+"        以 / 作为分隔符
h[$2]++          【核心】数组h,以域名为下标,次数+1
END              所有行处理完执行
for(i in h)      遍历数组所有域名
print i,h[i]     打印域名和次数
sort -k2 -nr     按第2列数字倒序排序(次数从大到小)
详细解释
# 功能:按'/'分割网址,提取域名,使用awk【关联数组】统计每个域名出现次数
# 最终按出现次数从高到低排序输出:域名 次数

awk -F "[/]+" '              # -F "[/]+":分隔符,以斜杠 / 分割每行
{
    h[$2]++;                 # h[$2]++:awk关联数组计数
                             # h      = 数组名称
                             # $2     = 数组下标(key,域名)
                             # h[$2]  = 数组值(value,域名出现次数)
                             # ++     = 每出现一次,计数+1
}
END {                        # 所有行处理完成后执行
    for(i in h)              # 遍历数组h,i依次代表每个域名
        print i, h[i];       # 输出:域名 + 总次数
}' web_file.txt | sort -k2 -nr

# sort -k2 -nr:管道传给sort排序
# -k2  按第2列(次数)排序
# -n   按数字排序
# -r   倒序(从大到小)